DeepSeek, Mistral e l'IA che gira sul tuo computer
In Italia la parola «deepseek» si cerca su Google circa 301.000 volte al mese. «Ollama», il nome di un programma che fa girare l'intelligenza artificiale direttamente sul computer, arriva a 22.200 ricerche, più del doppio di un anno fa, e «lm studio», un programma simile, a 12.100. Sono i dati del Keyword Planner di Google sull'ultimo anno, e secondo me raccontano una curiosità precisa. Molte persone hanno sentito dire che esistono IA «aperte» che si possono usare senza mandare i propri testi a un'azienda, e vogliono capire se è vero.
È vero, ma con alcune condizioni che vale la pena conoscere prima di installare qualcosa. In questo articolo provo a metterle in ordine, partendo dal caso più cercato, DeepSeek, che è anche quello che crea più confusione.
Un'app e un modello non sono la stessa cosa
Quando si dice «DeepSeek» si parla di due cose diverse.
La prima è il servizio, cioè il sito e l'app dove scrivi le domande. La sua informativa privacy, aggiornata il 10 febbraio 2026, dice in modo esplicito che i dati personali vengono raccolti, trattati e conservati nella Repubblica popolare cinese. Il 30 gennaio 2025 il Garante privacy ha disposto la limitazione del trattamento dei dati degli utenti italiani, salva ogni altra decisione alla fine dell'istruttoria, e sul sito del Garante non risultano provvedimenti successivi. Il 21 ottobre 2026 l'app non risultava disponibile nell'App Store italiano, mentre in Germania sì, anche se a giugno 2025 la Commissaria per la protezione dei dati di Berlino l'aveva segnalata ad Apple e Google come contenuto illecito, per il trasferimento dei dati in Cina. In Italia anche l'Antitrust se n'è occupata, ma per un altro motivo, cioè l'avviso agli utenti sulle risposte inventate (le cosiddette allucinazioni), e ha chiuso il procedimento nel dicembre 2025 accettando gli impegni dell'azienda.
La seconda cosa è il modello, cioè il file con i parametri che l'IA ha imparato durante l'addestramento, chiamati pesi. DeepSeek li pubblica su Hugging Face con licenza MIT, una delle più permissive che esistano. Chiunque può scaricarli e farli girare sui propri server, e in quel caso i testi non passano dall'azienda cinese. C'è però un dettaglio che cambia tutto. L'ultimo modello, pubblicato il 17 ottobre 2026, ha circa 763 miliardi di parametri, e un portatile non lo può far girare (lo vedremo tra poco con i numeri).
Per questo quando qualcuno ti dice «DeepSeek è aperto, quindi è sicuro» ha ragione solo a metà. Il modello è aperto, ma l'app che probabilmente hai in mente non lo è, e il modello completo richiede macchine da data center.
Aperto, ma quanto?
Anche la parola «aperto» merita attenzione, perché nell'IA si usa con significati diversi.
Nella maggior parte dei casi si parla di pesi aperti, cioè puoi scaricare il modello e usarlo, secondo una licenza che cambia da azienda ad azienda. Una cosa diversa è un modello open source nel senso pieno. Secondo la definizione pubblicata dall'Open Source Initiative, l'organizzazione che dal 1998 stabilisce cosa conta come open source nel software, servono tre cose insieme, i pesi, il codice completo usato per addestrare e far girare il modello, e informazioni sui dati di addestramento abbastanza dettagliate da poterne ricostruire uno equivalente. Pochi modelli famosi le soddisfano tutte.
Le licenze dei modelli più cercati, in breve.
- DeepSeek pubblica i suoi modelli recenti con licenza MIT, che permette anche l'uso commerciale.
- Mistral AI, l'azienda francese che ha creato Le Chat (oggi Vibe), pubblica con licenza Apache 2.0 una parte dei suoi modelli, tra cui la famiglia Ministral 3, Mistral Small 4 e Mistral Large 3. Non vale per tutti, perché alcuni hanno licenze modificate, uno è riservato a usi non commerciali e altri restano proprietari.
- Llama di Meta usa una licenza propria che l'Open Source Initiative non considera open source. Per i modelli multimodali di Llama 4, quelli che capiscono anche le immagini, la licenza esclude chi ha domicilio o sede principale nell'Unione europea, mentre chi usa un prodotto che li contiene non è toccato da questa esclusione.
La conclusione pratica, secondo me, è leggere sempre la licenza del modello che scarichi, soprattutto se pensi di usarlo per lavoro.
Quanta memoria serve per farla girare a casa
Qui entra in gioco una regola semplice. Hugging Face, la piattaforma dove si pubblicano molti di questi modelli, spiega che per caricare un modello in precisione a 16 bit servono circa 2 GB di memoria per ogni miliardo di parametri. I programmi per l'uso in locale spesso usano versioni compresse a 4 bit, che occupano un quarto di quello spazio. Ne ricavo, ed è un mio calcolo, che servono circa 0,5 GB per miliardo di parametri, più un margine per la conversazione in corso.
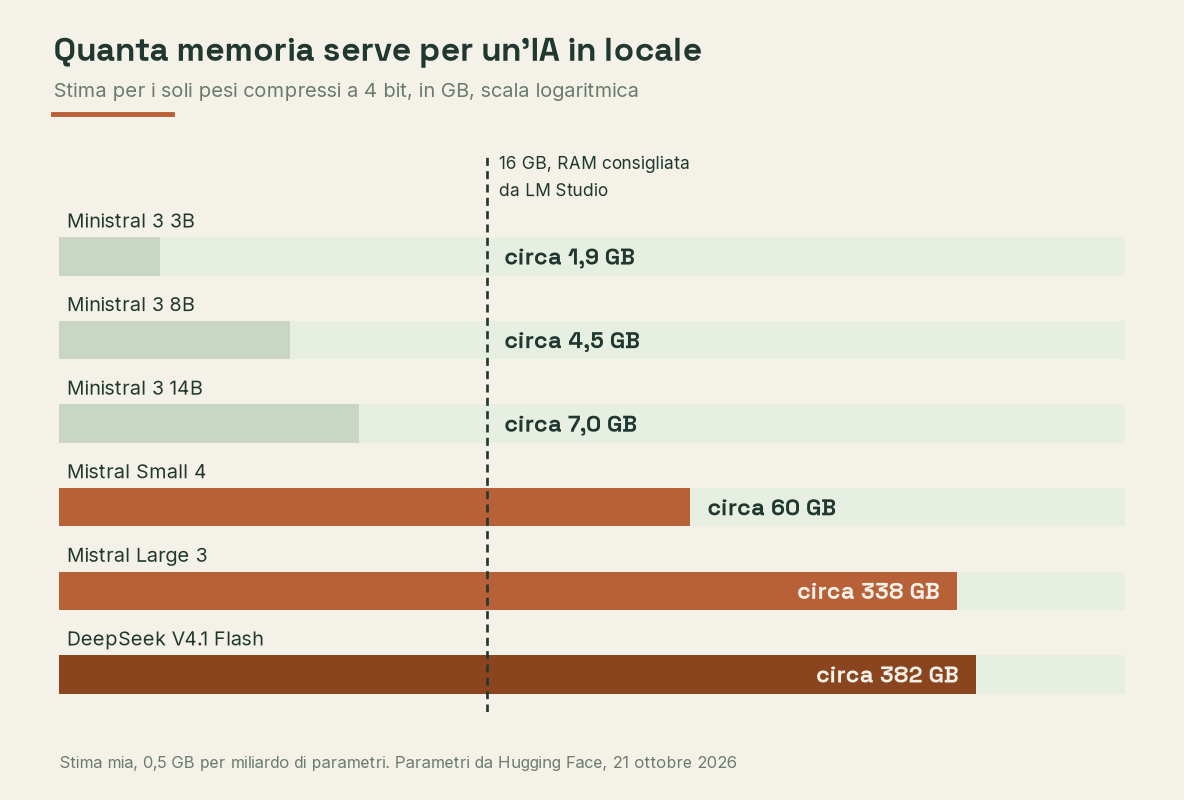
Memoria stimata solo per i pesi, compressi a 4 bit. Fonte, mio calcolo dalle dimensioni pubblicate su Hugging Face e dalla regola della documentazione di Hugging Face, consultate il 21 ottobre 2026.
Il grafico dice una cosa che le pubblicità non dicono. I modelli piccoli, da 3 a 14 miliardi di parametri, stanno in un computer recente con 16 GB di RAM, che è la quantità consigliata da LM Studio. I modelli grandi di cui si parla sui giornali no, servono centinaia di gigabyte. In locale quindi userai un modello più piccolo, che risponde bene a domande semplici, riassunti e riscritture, ma sbaglia più spesso di un servizio online su compiti complessi.
Ollama, LM Studio e GPT4All a confronto
Per usare un modello sul computer serve un programma che lo scarichi e lo faccia girare. I tre più cercati in Italia tra quelli che ho misurato sono diversi tra loro, e conviene sapere come.
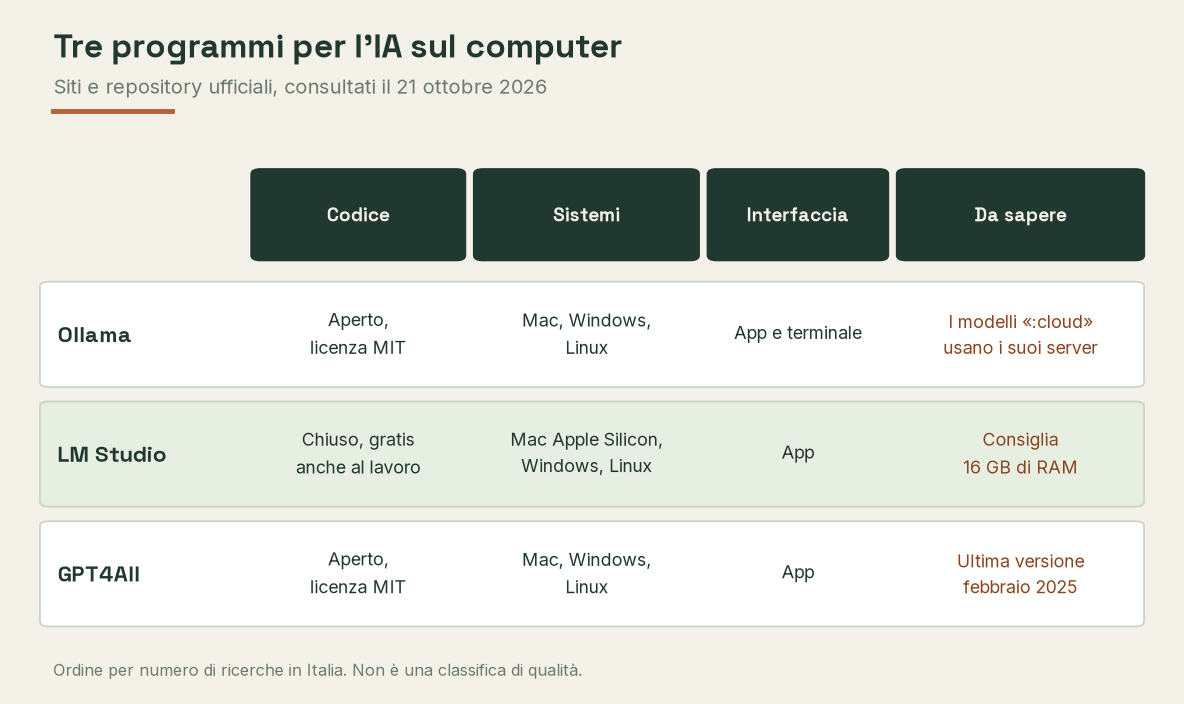
Tre programmi per usare l'IA sul computer. Fonte, siti ufficiali e repository dei programmi, consultati il 21 ottobre 2026.
Ollama è gratuito e il suo codice è aperto con licenza MIT. Funziona su macOS, Windows e Linux e dal luglio 2025 ha anche un'app con finestre e pulsanti, oltre al terminale. Nella sua documentazione scrive che quando lo usi in locale l'azienda non vede le tue richieste né i tuoi dati. C'è però un'avvertenza importante. Ollama offre anche modelli cloud, riconoscibili dalla sigla «:cloud» nel nome, e in quel caso le richieste vengono elaborate sui server di Ollama. Se vuoi essere sicuro di restare in locale, la documentazione spiega come spegnere le funzioni cloud, con la variabile OLLAMA_NO_CLOUD=1 oppure con l'impostazione "disable_ollama_cloud": true nel file ~/.ollama/server.json.
LM Studio è il più semplice da usare per chi non ama il terminale. Dall'8 luglio 2025 è gratuito anche per il lavoro, ma il suo codice non è aperto. Sul Mac richiede un processore Apple Silicon e macOS 14 o successivo, su Windows un processore con istruzioni AVX2, e in entrambi i casi consiglia 16 GB di RAM.
GPT4All è aperto con licenza MIT e funziona anche senza scheda grafica, solo con il processore. L'ultima versione però è del febbraio 2025, per cui oggi lo considero meno adatto di Ollama e LM Studio.
Cosa cambia per la privacy, e cosa no
Con un modello in locale le tue domande non partono verso un'azienda, e per chi lavora con dati delicati è un vantaggio enorme. Restano però alcune cose da sapere.
- Scarica i modelli solo da fonti ufficiali, come le pagine delle aziende su Hugging Face o le librerie integrate nei programmi.
- Controlla le funzioni che usano internet, come i modelli cloud o la ricerca web, perché lì i testi escono dal computer.
- Ricontrolla le risposte, perché un modello piccolo sbaglia più spesso.
- I dati personali restano dati personali. Se a scuola o in uno studio professionale tratti dati di altre persone, anche con uno strumento in locale le scelte vanno fatte con il responsabile della protezione dei dati del tuo ente.
Lo stesso principio, cioè fare il lavoro delicato sul computer prima che qualcosa vada online, è quello su cui si basa l'Anonimizzatore IA che distribuiamo gratuitamente per macOS e Windows. Il riconoscimento dei dati personali avviene sul tuo computer, i documenti restano lì, e solo dopo puoi incollare il testo con i segnaposto in qualunque chatbot, anche online. Il risultato va sempre ricontrollato, perché nessuno strumento riconosce tutto. Se vuoi capire come funzionano i segnaposto, ne ho scritto nella guida su come anonimizzare i testi per i chatbot, e se usi le versioni online gratuite trovi il confronto nell'articolo sulle IA gratuite e i tuoi dati.
Se vuoi ricevere aggiornamenti come questo, e la licenza gratuita dell'Anonimizzatore IA, crea il tuo account gratuito su retoria.it. Se invece vuoi provare l'IA in locale con i colleghi della tua scuola o del tuo ufficio, guidati passo passo, scrivici.
Nota metodologica
Ho letto il 21 ottobre 2026 le pagine ufficiali dei servizi e dei programmi (informative privacy, documentazione, licenze, schede dei modelli su Hugging Face) e i provvedimenti delle autorità. La disponibilità dell'app DeepSeek negli App Store italiano e tedesco l'ho controllata quel giorno con il servizio di ricerca ufficiale di Apple. Per Google Play non ho un dato verificato.
La memoria nel grafico è una stima mia, ottenuta moltiplicando i parametri pubblicati su Hugging Face per 0,5 GB a miliardo, cioè un quarto dei 2 GB a miliardo indicati da Hugging Face per la precisione a 16 bit. Riguarda solo i pesi, e nella pratica serve un margine in più che cresce con la lunghezza della conversazione. Il parametro di Mistral Large 3 è quello indicato nel nome del modello.
Non ho trovato indicazioni ufficiali italiane (Garante, AgID, Ministero dell'Istruzione) che raccomandino l'uso di modelli in locale. I volumi di ricerca vengono dal Keyword Planner di Google per l'Italia, da ottobre 2025 a settembre 2026. Questo articolo non è una consulenza legale.
Fonti
- DeepSeek, informativa privacy (aggiornata il 10 febbraio 2026) e modelli su Hugging Face, con la scheda di DeepSeek V4.1 Flash (17 ottobre 2026, licenza MIT).
- Garante per la protezione dei dati personali, provvedimento di limitazione nei confronti di DeepSeek (30 gennaio 2025).
- Commissaria per la protezione dei dati e la libertà d'informazione di Berlino, comunicato su DeepSeek (27 giugno 2025).
- Autorità garante della concorrenza e del mercato, comunicato sulla chiusura del procedimento PS12942 con impegni (dicembre 2025).
- Mistral AI, panoramica dei modelli, schede su Hugging Face di Ministral 3 8B, Mistral Small 4 e Mistral Large 3, e pagina sul passaggio da Le Chat a Vibe (12 agosto 2026).
- Meta, politica d'uso accettabile di Llama 4, e Open Source Initiative, articolo sulla licenza di Llama.
- Open Source Initiative, Open Source AI Definition 1.0.
- Hugging Face, documentazione sull'ottimizzazione dei modelli linguistici.
- Ollama, domande frequenti, pagina sui modelli cloud e annuncio della nuova app (30 luglio 2025).
- LM Studio, annuncio dell'uso gratuito per il lavoro (8 luglio 2025), condizioni d'uso (23 agosto 2026) e requisiti di sistema.
- Nomic AI, pagina di GPT4All e repository su GitHub.
- Google, Keyword Planner, volumi medi mensili di ricerca in Italia (ottobre 2025, settembre 2026), consultati il 21 ottobre 2026.