Anonimizzare i testi per i chatbot senza perdere il contesto
Pensa a un chatbot come a un collaboratore bravissimo che non ha bisogno di sapere chi sono le persone di cui gli parli. Per riassumere un verbale, riscrivere una lettera o preparare la risposta a un reclamo gli servono i fatti, l'ordine in cui sono successi, i ruoli di ciascuno e il tono giusto. Il nome, il codice fiscale o l'indirizzo della signora Rossi non migliorano di una virgola il suo lavoro. Eppure sono proprio quei dati che, ogni giorno, finiscono incollati nella finestra della chat (e, come vedremo con i numeri, circa la metà di chi usa l'IA al lavoro lo fa anche con dati dei clienti e dell'azienda).
Anonimizzare un testo prima di darlo a un chatbot serve a separare queste due cose. Togli ciò che identifica le persone e tieni tutto il resto. Il punto delicato è come lo togli. Se cancelli i dati, o li copri con degli asterischi, il modello perde il filo. Non sa più chi ha scritto a chi, chi ha firmato cosa, a quale persona si riferisce una frase, e la risposta peggiora. Se invece al posto di ogni dato metti un segnaposto (in inglese placeholder) come [NOME 1], [AZIENDA A] o [DATA], il contesto resta intatto. Il chatbot capisce che si parla di una persona, di un'azienda o di una data, distingue chi è chi e lavora come se avesse davanti il testo originale.
È così che usi i chatbot al massimo delle loro capacità senza rinunciare alla riservatezza. Lavori sullo stesso testo, ottieni risposte della stessa qualità e le persone di cui parli restano fuori dalla conversazione. Quando la risposta torna sul tuo computer, rimetti i dati veri al loro posto. Ed è anche la strada più vicina allo spirito delle regole europee sulla protezione dei dati, che chiedono di usare solo i dati che servono davvero e di proteggerli fin dall'inizio.
In questo articolo vediamo cosa vuol dire anonimizzare un testo, quali strade esistono, come funziona l'Anonimizzatore IA di Retoria, quanto tempo ti fa risparmiare e come farlo da domani in cinque passaggi. È materiale divulgativo, non consulenza legale.
L'anonimizzazione, la famiglia che nasconde l'identità
Quando in questo articolo parliamo di anonimizzazione intendiamo la famiglia di tutti i processi che nascondono l'identità delle persone e i dati sensibili contenuti in un testo. È il senso in cui la usiamo noi di Retoria, ed è il motivo per cui la nostra app si chiama Anonimizzatore IA. Dentro questa famiglia, però, ci sono due strade molto diverse.
La prima è la pseudonimizzazione. Sostituisci i dati con dei segnaposto (in inglese placeholder) che dicono al chatbot di che tipo di informazione si tratta senza rivelarla, per esempio [NOME], [COGNOME] o [CODICE FISCALE], e tieni da parte una tabella di corrispondenza che ti permette di rimettere i dati veri. La seconda è l'anonimizzazione totale. Togli i dati o li generalizzi finché non si può più risalire alla persona, e non conservi nessuna chiave. La prima nasconde l'identità e ti lascia la strada per tornare indietro, la seconda la cancella per sempre.
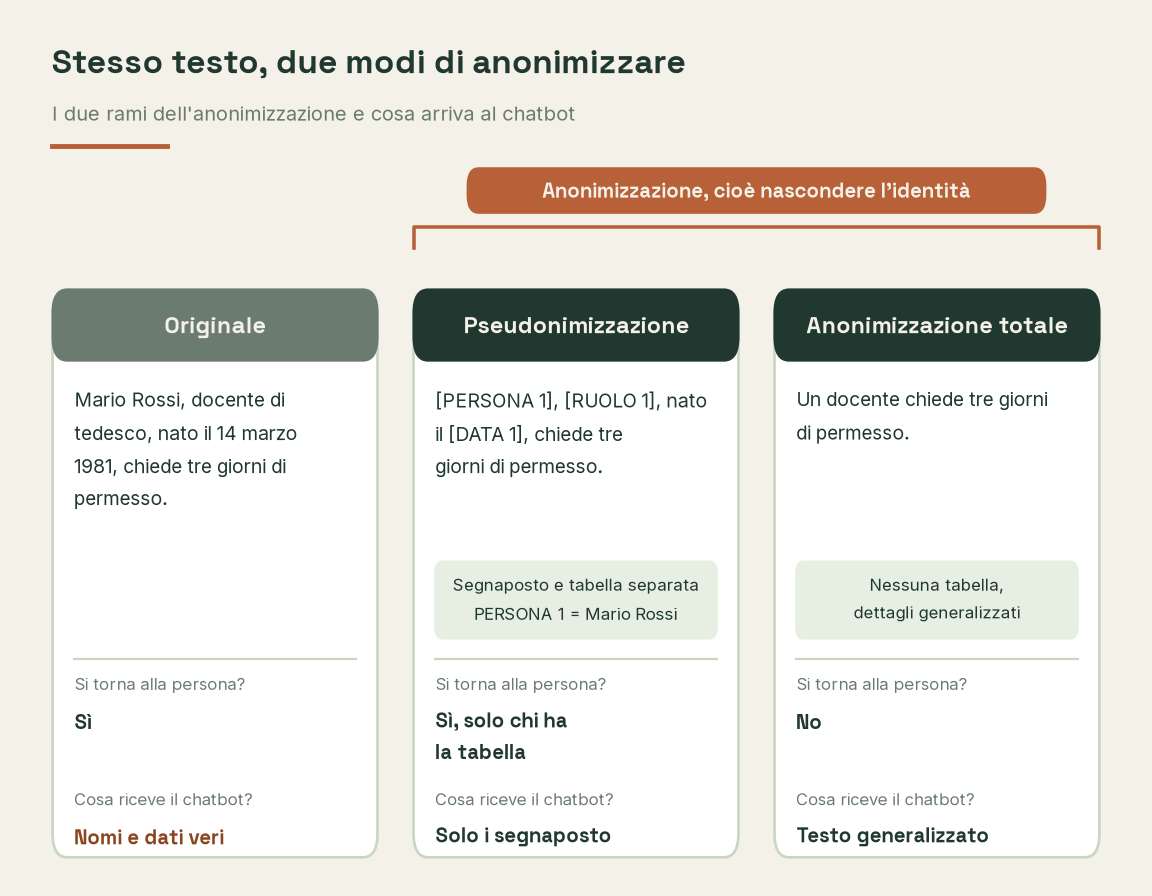 Lo stesso testo trattato con i due rami dell'anonimizzazione. La pseudonimizzazione nasconde i dati e permette a chi ha la tabella di rimetterli, l'anonimizzazione totale li cancella. Elaborazione Retoria su GDPR e indicazioni delle autorità europee per la protezione dei dati.
La pseudonimizzazione, ovvero nascondere i dati e tenere la chiave
È il ramo che serve di più a chi lavora con i chatbot. Anche il GDPR la conosce bene e la descrive, in sostanza, come un modo di trattare i dati per cui non si possono più attribuire a una persona precisa senza informazioni aggiuntive, da conservare a parte e da proteggere.
In pratica sostituisci gli identificativi con segnaposto (o, più raramente, con nomi di fantasia) e tieni da qualche parte una tabella di corrispondenza (Persona 1 corrisponde a Mario Rossi, Ente A all'ufficio tributi del tuo Comune). Chi ha la tabella può tornare indietro. Chi non ce l'ha vede solo segnaposto.
Perché conviene? Perché il GDPR la indica espressamente tra le misure che proteggono i dati, e le autorità europee per la protezione dei dati spiegano che riduce i rischi per le persone, perché impedisce di attribuire i dati a qualcuno mentre li usi e anche nel caso di un accesso non autorizzato. Con i segnaposto, inoltre, il chatbot conserva tutto il contesto che gli serve per lavorare bene. E siccome tieni la chiave, puoi sempre tornare al testo originale, che è proprio ciò che serve quando lavori con un chatbot.
L'anonimizzazione totale, ovvero non poter più tornare indietro
L'anonimizzazione totale è il ramo più radicale della famiglia. Un dato è anonimo in questo senso stretto quando non si può più ricondurre a nessuna persona, tenendo conto di tutti i mezzi che qualcuno potrebbe ragionevolmente usare per farlo.
Le autorità europee per la protezione dei dati riassumono questo criterio in tre domande. È ancora possibile isolare una persona dentro i dati? È possibile collegare fra loro dati che riguardano la stessa persona? È possibile dedurre qualcosa su di lei? Solo se la risposta è no per tutte e tre il dato può dirsi anonimo in senso stretto.
La soglia è alta, e la ricerca mostra perché. Nel 2000 Latanya Sweeney, alla Carnegie Mellon University, ha calcolato che con i dati del censimento statunitense del 1990 bastavano tre informazioni, cioè CAP, data di nascita e sesso, per riconoscere in modo univoco l'87% delle persone. Nessun nome, nessun codice fiscale. Sostituendo il CAP con il comune la quota scendeva al 53%, e indicando solo la contea al 18% (negli Stati Uniti la contea è il livello amministrativo tra il comune e lo stato, un po' come da noi la provincia). Sono dati americani, ma il meccanismo è lo stesso ovunque. Il dettaglio geografico, insomma, pesa più del nome. Nel 2019 Luc Rocher, Julien Hendrickx e Yves-Alexandre de Montjoye hanno poi stimato su Nature Communications che con 15 attributi demografici il 99,98% degli statunitensi verrebbe reidentificato correttamente in qualunque insieme di dati, anche incompleto (è una stima da modello statistico e non una prova su un archivio reale, ma la direzione è chiara). Più dettagli lasci, più la persona torna visibile. E non vale solo per i dati anagrafici. Nel 2008 Arvind Narayanan e Vitaly Shmatikov hanno mostrato che l'archivio «anonimo» delle valutazioni di film pubblicato da Netflix per un concorso, circa 500.000 abbonati, si poteva ricollegare alle persone confrontando poche valutazioni con quelle pubblicate su IMDb, al punto da far emergere anche preferenze sensibili.
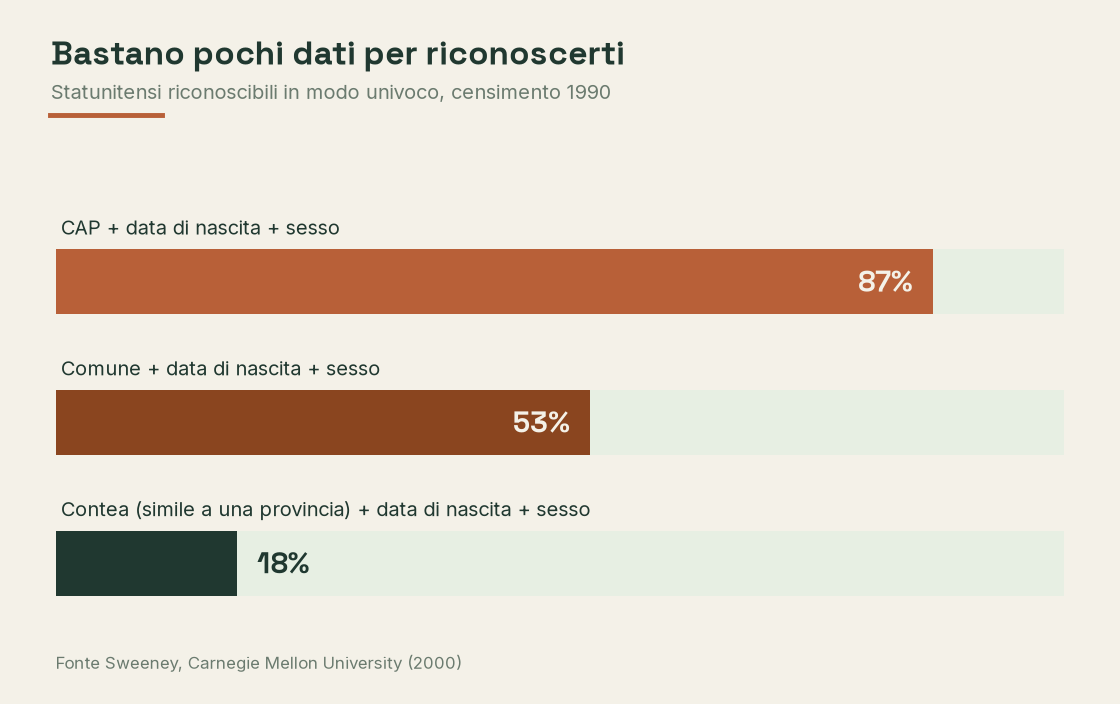 Quante persone si riconoscono in modo univoco con data di nascita, sesso e un dato geografico sempre più preciso. Fonte Sweeney, Carnegie Mellon University (2000), su dati del censimento statunitense del 1990.
Per questo un dato anonimo in senso stretto, di solito, è un dato trasformato in profondità (aggregato, generalizzato, con il dettaglio che sparisce) e non semplicemente un dato senza nome. E per lo stesso motivo le autorità europee avvertono che nemmeno un modello di IA addestrato su dati personali si può considerare sempre anonimo, visto che in certi casi quei dati si possono estrarre dal modello stesso.
Per chi lavora con i chatbot, però, l'anonimizzazione totale ha un costo. Più generalizzi, più il testo perde dettagli, e con i dettagli perde utilità. Una relazione in cui tutte le persone diventano «qualcuno» e tutte le date «un giorno» non si riassume né si riscrive bene. Per questo, quando l'obiettivo è lavorare con l'IA, la strada più pratica è di solito quella dei segnaposto.
Dove sta la chiave
Nel 2025 anche la Corte di giustizia dell'Unione europea è tornata sui dati pseudonimizzati, ricordando che per valutarli conta molto chi ha davvero i mezzi per risalire alle persone.
Tradotto per chi lavora con un chatbot, conta molto dove sta la chiave. Se la tabella di corrispondenza resta sul tuo computer e al fornitore del servizio arriva solo il testo con i segnaposto, hai ridotto in modo concreto ciò che quel fornitore può sapere delle persone di cui parli.
Quanti dati aziendali finiscono già nei chatbot pubblici
Non è un rischio teorico, è un'abitudine. Lo studio di Kristjan Prenga che citiamo più avanti dedica un intero capitolo a questi dati, e i numeri del rapporto originale dell'Università di Melbourne e di KPMG sono netti. Il 58% dei lavoratori usa l'IA in modo intenzionale e regolare, quasi sempre con strumenti gratuiti e pubblici come ChatGPT invece di quelli forniti dal datore di lavoro. Circa la metà di chi la usa (dal 48 al 49%) ha caricato in strumenti pubblici informazioni aziendali sensibili, cioè dati finanziari, dati di vendita o informazioni sui clienti, oppure materiale protetto da diritto d'autore. Il 56% ha usato l'IA al lavoro senza sapere se fosse permesso, e il 63% ha visto colleghi usarla in modo scorretto.
Il dato più istruttivo è un altro. Caricare dati sensibili è più frequente dove l'IA è vietata (67%) e dove esiste una regola interna (56%) che dove non c'è nessuna regola (33%). Il divieto, insomma, non ferma l'uso, lo rende solo invisibile (ne abbiamo parlato nell'articolo sullo shadow AI). Il caso più noto resta quello di Samsung, che nel maggio 2023 ha sospeso l'uso dei chatbot sui dispositivi aziendali dopo che alcuni ingegneri avevano incollato in ChatGPT codice sorgente interno.
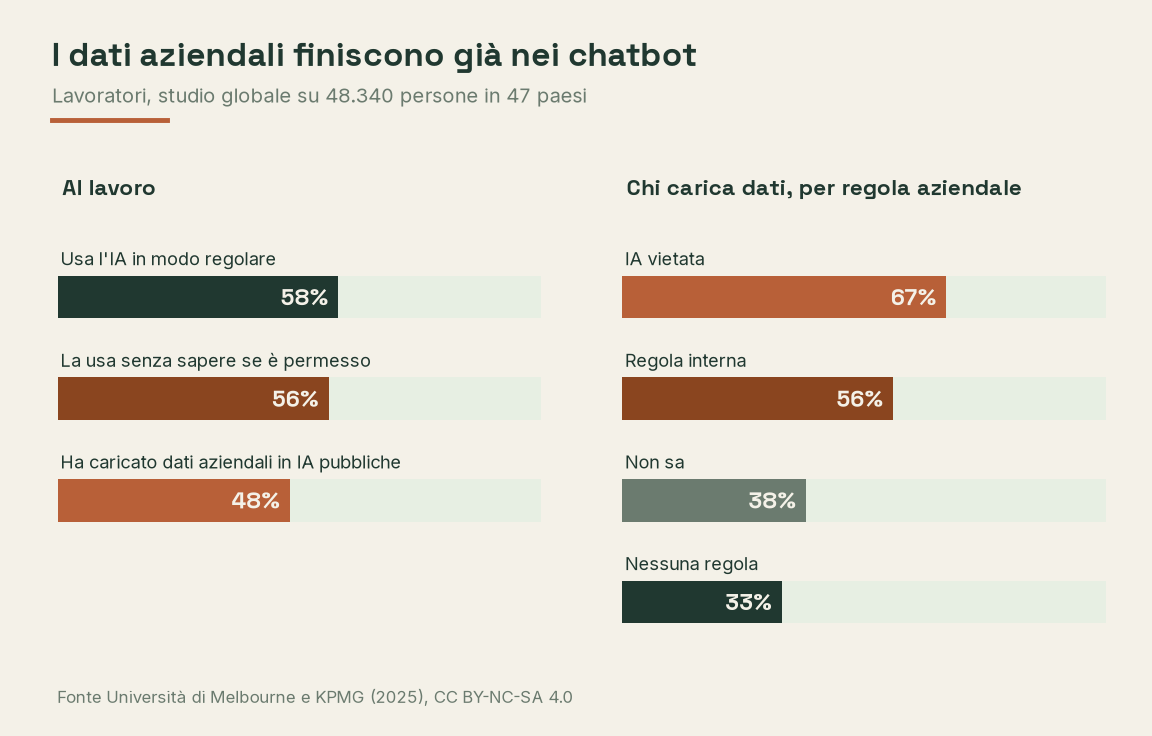 Uso dell'IA al lavoro e caricamento di dati aziendali sensibili in strumenti pubblici, per tipo di regola aziendale. Fonte Università di Melbourne e KPMG (2025), 48.340 persone in 47 paesi.
E una volta lì dentro? Le app di chatbot raccolgono molto più del testo che scrivi. Secondo l'analisi di Surfshark aggiornata a marzo 2026 sulle dieci app di IA più scaricate dall'App Store, in media ognuna raccoglie 14 tipi di dati su 35 possibili (Meta AI 33, Gemini 23, ChatGPT 17), e il 70% raccoglie la posizione. Poi ci sono gli incidenti. A gennaio 2025 i ricercatori di Wiz hanno trovato un database di DeepSeek accessibile a chiunque, senza password, con oltre un milione di righe di registro che contenevano anche conversazioni degli utenti e chiavi di accesso. A febbraio 2025 un attaccante ha dichiarato di aver pubblicato i contatti di circa 30.000 utenti di OmniGPT e oltre 34 milioni di righe di conversazioni (una rivendicazione che la piattaforma non ha confermato pubblicamente).
Per un'organizzazione questo non va bene per due ragioni distinte. I dati dei clienti, dei pazienti o degli studenti sono dati personali, e il GDPR chiede di usare solo quelli che servono davvero e di proteggerli. Incollarli interi in un servizio esterno va nella direzione opposta. I dati aziendali (contratti, numeri, strategie) non sono protetti dal GDPR, ma una volta usciti non li controlli più. In entrambi i casi la soluzione non è smettere di usare l'IA, è smettere di darle ciò che non le serve.
Perché con i chatbot la differenza diventa pratica
Un testo che incolli in un chatbot esce dal tuo controllo. Viene trasmesso, elaborato, spesso conservato, e a seconda del servizio e delle impostazioni può finire anche tra i dati usati per migliorare i modelli. Che i modelli possano trattenere ciò che vedono non è un'ipotesi da convegno. Nel 2021 Nicholas Carlini e colleghi hanno estratto da GPT-2 centinaia di sequenze del suo testo di addestramento parola per parola, compresi nomi, numeri di telefono e indirizzi email, anche quando comparivano in un solo documento.
La regola utile, allora, è semplice. Al modello serve la struttura del tuo testo (cosa è successo, in che ordine, con quale tono) e quasi mai l'identità delle persone. Se gli chiedi di riscrivere in modo più formale una lettera a «Persona 1», il risultato è lo stesso che con il nome vero, e il nome lo rimetti tu dopo.
L'Anonimizzatore IA, come funziona e quanto tempo ti fa risparmiare
Tutto quello che abbiamo descritto finora si può fare a mano. Ma se lo fai ogni giorno, su verbali, relazioni e mail, diventa un lavoro lungo e facile da sbagliare. Per questo noi di Retoria distribuiamo gratuitamente l'Anonimizzatore IA, un'app open source per Mac e Windows ideata da Kristjan Prenga. Si chiama così perché il suo compito è anonimizzare i testi, cioè nascondere l'identità delle persone di cui parlano, e per farlo usa la pseudonimizzazione con i segnaposto. Il riconoscimento dei dati avviene sul tuo computer, e i tuoi documenti restano lì.
Funziona in tre passi. Carichi o registri il materiale, e l'app riconosce nomi, codici fiscali, IBAN, indirizzi e altri tipi di dati personali (oltre venti in tutto) e li sostituisce con segnaposto come [FULLNAME_1] o [CITY_1]. Copi il testo anonimizzato nel chatbot che preferisci (ChatGPT, Claude, Gemini) e gli chiedi quello che ti serve. Poi incolli la risposta nell'app e, con il ponte inverso, nomi e dati veri tornano al loro posto. La tabella di corrispondenza resta sul tuo computer.
Cosa può fare, con i video tutorial
Per ogni funzione c'è un breve video che ti mostra come si usa.
- Documenti PDF. Contratti, delibere, circolari, relazioni. L'app trova i dati personali nel testo e li sostituisce. Guarda il tutorial
- Scansioni e documenti cartacei. L'OCR legge le pagine scansionate sul tuo computer, ne estrae il testo e lo anonimizza. Guarda il tutorial
- Immagini e screenshot. La foto di una pagina, di una lavagna o di una chat diventa testo pulito, pronto da copiare. Guarda il tutorial
- File audio. Registrazioni di riunioni, interviste o lezioni (MP3, WAV, M4A) trascritte e anonimizzate in locale. Guarda il tutorial
- Registrazione dal vivo. Registri dal microfono durante un incontro e, quando ti fermi, l'app trascrive e anonimizza il parlato. Guarda il tutorial
- Ponte inverso. Incolli la risposta dell'IA e l'app rimette al loro posto i nomi e i dati reali, per avere subito il documento finale. Guarda il tutorial
Testi e PDF digitali funzionano subito, senza registrazione. Per scansioni, immagini, audio e registrazione serve il codice di attivazione gratuito che ottieni registrandoti su retoria.it.
Quanto tempo fa risparmiare, i numeri di una prova pratica
In un nostro laboratorio di formazione 14 partecipanti hanno anonimizzato lo stesso testo di circa una pagina, prima a mano e poi con l'app, cronometrando ogni passaggio e dando un voto al risultato. Ecco i valori centrali (le mediane).
A mano ci sono voluti circa tre minuti e mezzo, con 14 dati personali individuati e una qualità valutata 7,5 su 10. L'app ha fatto lo stesso lavoro in 33 secondi e ha individuato 17 dati, con una qualità di 8 su 10 già prima di qualunque correzione. Dopo una revisione di circa due minuti e mezzo, il testo finale è arrivato a 9,5 su 10.
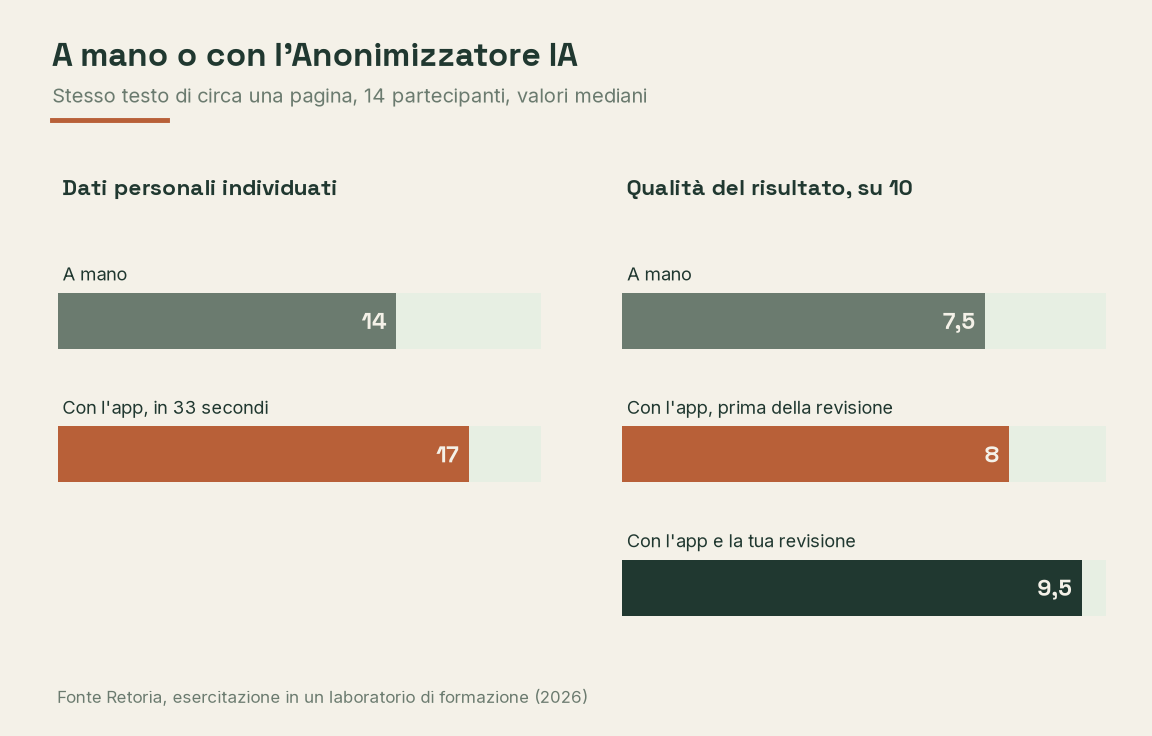 Lo stesso testo anonimizzato a mano e con l'Anonimizzatore IA. Valori mediani su 14 partecipanti, qualità valutata dai partecipanti stessi. Fonte Retoria, esercitazione in un laboratorio di formazione (2026).
Su un testo così breve, insomma, il tempo totale con la revisione è simile a quello del lavoro a mano, ma il risultato è molto più completo e più sicuro. La correzione più frequente, segnalata da 11 partecipanti su 14, ha riguardato gli identificativi indiretti, quei dettagli senza nome che solo chi conosce il contesto sa riconoscere. È il motivo per cui la tua rilettura resta indispensabile, e per cui la qualità migliore arriva dalla collaborazione tra l'app e la persona.
Un esempio concreto, il verbale di una riunione
Il risparmio di tempo vero si vede quando l'anonimizzazione è un passaggio di un lavoro più lungo. Pensa a una riunione di un'ora. Con il metodo di sempre prendi appunti mentre gli altri parlano, poi li riordini, scrivi il verbale e lo rileggi. Tra una cosa e l'altra se ne vanno facilmente un paio d'ore.
Con l'app registri la riunione (oppure carichi il file audio), la trascrivi e la anonimizzi sul tuo computer. Copi il testo nel chatbot e gli chiedi un verbale con la struttura che usi di solito. Incolli la risposta nell'app e il ponte inverso rimette i nomi. Il lavoro che resta a te si riduce a pochi minuti, più o meno cinque, oltre alla rilettura finale, perché la trascrizione la fa il computer. E il verbale nasce da tutto quello che è stato detto, non solo da quello che sei riuscito ad annotare. Lo stesso schema vale per un colloquio, una relazione da scrivere a partire da appunti vocali o una risposta a un reclamo.
E le risposte del chatbot restano buone?
È l'obiezione che si sente più spesso, cioè che togliendo i dati l'IA risponda peggio. Lo studio Enterprise and personal data protection through anonymization and pseudonymization di Kristjan Prenga, presidente di Retoria (2025, disponibile tramite il suo sito), l'ha messa alla prova su 42 testi realistici, con un prototipo che maschera il testo in locale prima di inviarlo a un modello in cloud e poi rimette i dati reali nella risposta. Una volta ripristinati i nomi, le risposte ai testi con i segnaposto avevano una somiglianza semantica media del 92% con quelle ai testi originali, e un secondo modello usato come giudice le ha valutate in media 9,67 su 10 contro 9,81, una differenza che non risulta statisticamente significativa. Lo studio mostra anche che i segnaposto funzionano meglio dei nomi di fantasia, perché con i segnaposto il filtro ha individuato il 93,1% dei dati sensibili contro l'84,8%. Va nella stessa direzione il lavoro di Stefan Pasch e Min Chul Cha, presentato nel 2025 al workshop PrivateNLP, che su lettere di presentazione, email e testi personali ha mascherato dal 97 al 99% dei dati con un calo di qualità di circa un punto su dieci. Raccontiamo lo studio di Prenga più nel dettaglio nell'articolo Anonimizzare prima dell'IA, il gesto che quasi nessuno fa.
Come farlo domani, in cinque passaggi
Non serve un ufficio legale per cominciare. Serve un metodo, e questo è quello che ti consigliamo.
- Chiediti se all'IA serve sapere chi è. Quasi sempre no. Per un riassunto, una riscrittura o una traduzione l'identità delle persone non cambia il risultato.
- Sostituisci gli identificativi diretti con segnaposto coerenti. Nomi, codici fiscali, IBAN, indirizzi, email, numeri di telefono. Usa lo stesso segnaposto per la stessa persona in tutto il testo (Persona 1 resta Persona 1), altrimenti il modello si confonde.
- Guarda anche gli identificativi indiretti. Un ruolo unico, una data precisa, un luogo piccolo, una malattia rara. Da soli sembrano innocui, insieme possono bastare. Dove puoi generalizza, cioè scrivi un docente invece del docente di tedesco, ottobre invece del 14 ottobre.
- Tieni la tabella di corrispondenza fuori dal prompt. Sul tuo computer, separata dal testo, mai incollata insieme alla domanda. È la differenza tra proteggere i dati e spostarli.
- Rileggi prima di inviare, e rimetti i nomi dopo. Nessun sistema automatico arriva al 100%, come mostrano anche i numeri qui sopra. Il controllo finale resta tuo.
Su un testo breve puoi fare tutto a mano. Quando diventa un'abitudine di ogni giorno, la sostituzione dei dati, la tabella di corrispondenza e il ripristino dei nomi li fa per te l'Anonimizzatore IA, sul tuo computer. Decidere cosa serve all'IA, controllare gli identificativi indiretti e rileggere restano compiti tuoi.
Da dove partire
La tecnica risolve il gesto, non l'abitudine. Se nella tua scuola, nel tuo ente o nel tuo studio nessuno sa quali dati non devono uscire, nemmeno lo strumento migliore basta. È per questo che nei nostri percorsi di formazione partiamo sempre da casi reali e dalle regole che servono a chi lavora ogni giorno con i documenti. Scrivici per organizzare un incontro con il tuo gruppo di lavoro, oppure prova subito l'Anonimizzatore IA sul primo testo che avresti incollato oggi in un chatbot. E se vuoi capire perché questa abitudine si forma già a scuola, leggi il nostro articolo sullo shadow AI.
Nota metodologica
Questo articolo ha finalità informative e divulgative e non costituisce consulenza legale. Per decisioni specifiche rivolgiti ai tuoi consulenti e al Responsabile della protezione dei dati della tua organizzazione.
In questo articolo usiamo «anonimizzazione» in senso ampio, come famiglia dei processi che nascondono l'identità delle persone. La pseudonimizzazione e l'anonimizzazione totale ne sono i due rami.
I dati di Sweeney si riferiscono alla popolazione degli Stati Uniti e al censimento del 1990, quindi mostrano un meccanismo e non una misura valida per l'Italia di oggi. Il 99,98% di Rocher, Hendrickx e de Montjoye è una stima ottenuta con un modello statistico, non il risultato di una reidentificazione su un archivio reale. I dati sull'uso dell'IA al lavoro vengono da un questionario (Università di Melbourne e KPMG, 48.340 persone in 47 paesi, raccolta tra novembre 2024 e gennaio 2025), quindi descrivono ciò che le persone dichiarano di fare.
I tempi e i voti dell'Anonimizzatore IA vengono da un'esercitazione pratica in un nostro laboratorio di formazione (settembre 2026), fatta con una versione dell'app precedente all'attuale 3.0.0. I 14 partecipanti hanno lavorato sullo stesso testo di circa 2.800 caratteri e hanno cronometrato e valutato da sé ogni passaggio. Riportiamo le mediane. Il campione è piccolo e i voti di qualità sono soggettivi, per cui i numeri descrivono un'esperienza concreta e non una misura generale. L'esempio del verbale è uno scenario indicativo e non una misura, perché i tempi dipendono dalla durata della riunione, dal computer e dalla cura della rilettura.
I risultati dello studio di Kristjan Prenga riguardano un prototipo dimostrativo e non un prodotto in uso. Addestramento e prova si basano su dati sintetici, generati con modelli diversi e controllati da una persona, su 42 testi e sei settori. I confronti sulla qualità delle risposte poggiano su sei gruppi per tecnica, una numerosità piccola che impone cautela, per cui l'assenza di differenze significative vuol dire che la prova non ha rilevato un peggioramento, non che un peggioramento sia impossibile. L'Anonimizzatore IA citato nell'articolo è un'applicazione diversa dal prototipo dello studio. I dati di Surfshark vengono dalle etichette sulla privacy dichiarate dagli sviluppatori sull'App Store, la fuga di dati di OmniGPT è una rivendicazione non confermata dalla piattaforma e il caso Samsung è noto dai resoconti della stampa sul documento interno dell'azienda.
Le indicazioni delle autorità europee per la protezione dei dati e la sentenza della Corte di giustizia del 2025 sono riassunte nei loro punti generali (i riferimenti completi sono nelle fonti) e vanno lette per intero prima di applicarle a un caso concreto. Le linee guida 01/2025 dell'European Data Protection Board sono citate nella versione adottata per la consultazione pubblica.
Fonti
- Sweeney, L., Simple Demographics Often Identify People Uniquely, Carnegie Mellon University, Data Privacy Working Paper 3 (2000).
- Rocher, L., Hendrickx, J. M., de Montjoye, Y.-A., Estimating the success of re-identifications in incomplete datasets using generative models, Nature Communications 10, 3069 (2019).
- Gillespie, N., Lockey, S., Ward, T., Macdade, A., Hassed, G., University of Melbourne e KPMG, Trust, attitudes and use of artificial intelligence. A global study 2025 (2025), licenza CC BY-NC-SA 4.0.
- Regolamento (UE) 2016/679, GDPR, articoli 4, 25 e 32 e considerando 26.
- Gruppo di lavoro Articolo 29, Parere 05/2014 sulle tecniche di anonimizzazione, WP216 (2014).
- European Data Protection Board, Guidelines 01/2025 on Pseudonymisation, versione per la consultazione pubblica adottata il 16 gennaio 2025.
- European Data Protection Board, Opinion 28/2024 on certain data protection aspects related to the processing of personal data in the context of AI models, adottato il 17 dicembre 2024.
- Corte di giustizia dell'Unione europea, sentenza del 4 settembre 2025, causa C-413/23 P, EDPS contro SRB.
- Carlini, N. e altri, Extracting Training Data from Large Language Models, USENIX Security Symposium (2021).
- Prenga, K., Enterprise and personal data protection through anonymization and pseudonymization: a privacy-by-design AI solution in the age of the AI Act (2025).
- Retoria, esercitazione pratica sull'anonimizzazione di un testo in un laboratorio di formazione, 14 partecipanti (settembre 2026), dati interni.
- Retoria, video tutorial dell'Anonimizzatore IA, sei video sul canale YouTube di Retoria (2026).
- Narayanan, A., Shmatikov, V., Robust De-anonymization of Large Sparse Datasets, IEEE Symposium on Security and Privacy (2008).
- Pasch, S., Cha, M. C., Balancing Privacy and Utility in Personal LLM Writing Tasks: An Automated Pipeline for Evaluating Anonymizations, PrivateNLP Workshop (2025).
- Surfshark, AI chatbots privacy, analisi delle app di IA sull'App Store, aggiornamento del 24 marzo 2026.
- Wiz Research, Wiz Research Uncovers Exposed DeepSeek Database Leaking Sensitive Information (29 gennaio 2025).
- CyberInsider, OmniGPT allegedly breached, 34 million user messages leaked (febbraio 2025).
- Bloomberg, notizia del 2 maggio 2023 sul divieto di Samsung all'uso dei chatbot di IA generativa sui dispositivi aziendali, ripresa da The National.