I rilevatori di IA funzionano? Cosa dicono gli studi
In Italia «ai detector» si cerca su Google circa 90.500 volte al mese, «ai detector italiano» 3.600 e «rilevatore ia» 2.400. Sono i dati del Keyword Planner di Google sull'ultimo anno, e dietro molte di queste ricerche immagino una scena precisa. Un docente ha davanti un compito che gli sembra troppo levigato, e cerca uno strumento che gli dica se l'ha scritto lo studente o un chatbot.
C'è però un altro numero che vale la pena guardare. «ai humanizer», cioè i programmi che riscrivono un testo per farlo sembrare umano e superare i rilevatori, ha 8.100 ricerche al mese. Da una parte c'è chi cerca di scoprire, dall'altra chi cerca di nascondere. In mezzo ci sono gli studenti, e la domanda che conta è una sola. Quanto ci si può fidare di questi strumenti quando in gioco c'è un voto, o un'accusa?
Come ragiona un rilevatore
Un rilevatore non trova una firma nascosta nel testo. Stima una probabilità, confrontando il testo con le caratteristiche statistiche tipiche della scrittura dei modelli linguistici, per esempio parole molto prevedibili e frasi molto regolari. Il risultato è un'ipotesi, non una prova.
Lo dicono gli stessi produttori. Turnitin, un servizio molto usato nelle università, scrive nella propria guida che il punteggio di scrittura IA non deve essere usato come unica base per prendere provvedimenti contro uno studente. Per questo, secondo me, prima di guardare i punteggi conviene guardare cosa dicono gli studi indipendenti.
Cosa dicono gli studi indipendenti
Il caso più noto è quello di OpenAI. A gennaio 2023 l'azienda di ChatGPT aveva pubblicato un proprio classificatore di testi. Nei suoi test riconosceva come «probabilmente scritto dall'IA» solo il 26% dei testi generati, e scambiava per IA il 9% dei testi scritti da persone. Il 20 luglio 2023 OpenAI l'ha ritirato, spiegando che l'accuratezza era troppo bassa.
Nello stesso anno un gruppo di ricercatori europei guidato da Debora Weber-Wulff ha messo alla prova 14 strumenti, tra cui Turnitin, su testi di sei tipi diversi. Nessuno ha raggiunto l'80% di accuratezza. Il quadro cambia molto a seconda del testo.
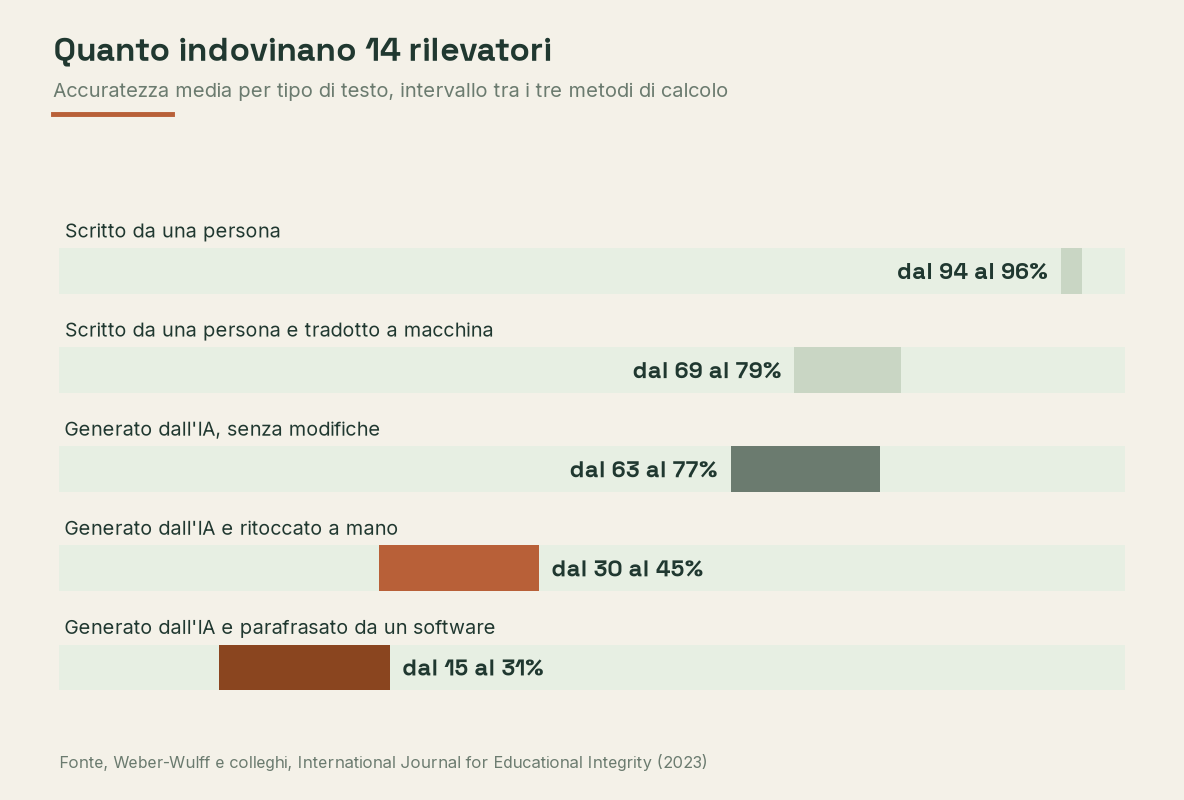
Accuratezza media di 14 rilevatori. L'intervallo va dal metodo di calcolo più severo al più favorevole tra i tre usati nello studio. Fonte, Weber-Wulff e colleghi, International Journal for Educational Integrity (2023).
Con i testi scritti da persone gli strumenti sbagliano poco. Con quelli generati dall'IA e poi ritoccati a mano, o fatti passare da un programma di parafrasi, la maggior parte sfugge. La conclusione degli autori è netta, gli strumenti testati non sono né accurati né affidabili e non andrebbero usati in ambito accademico.
Un anno dopo, nel 2024, Mike Perkins e colleghi hanno verificato quanto è facile aggirarli. Su 805 testi, i rilevatori riconoscevano i testi IA non modificati solo nel 39,5% dei casi, e con tecniche semplici come qualche errore di ortografia o frasi di lunghezza più varia l'accuratezza scendeva al 22,1%.
Gli strumenti però migliorano. Uno studio della Vrije Universiteit Brussel pubblicato nel giugno 2026, che ha confrontato GPTZero, Pangram, Copyleaks e Turnitin su 160 documenti, ha trovato falsi positivi rari sui testi interamente scritti da persone. Il rilevamento peggiorava invece sui testi misti e su quelli «umanizzati», e anche questi autori concludono che gli strumenti possono dare un primo segnale, ma non vanno mai usati come unica prova nelle decisioni importanti.
Chi rischia di più, chi scrive in una lingua non sua
C'è un risultato che, a mio parere, ogni docente dovrebbe conoscere. Nel 2023 un gruppo dell'Università di Stanford ha fatto analizzare a sette rilevatori i temi scritti da persone non madrelingua per il TOEFL, l'esame di inglese come lingua straniera, e i temi di studenti statunitensi di terza media.
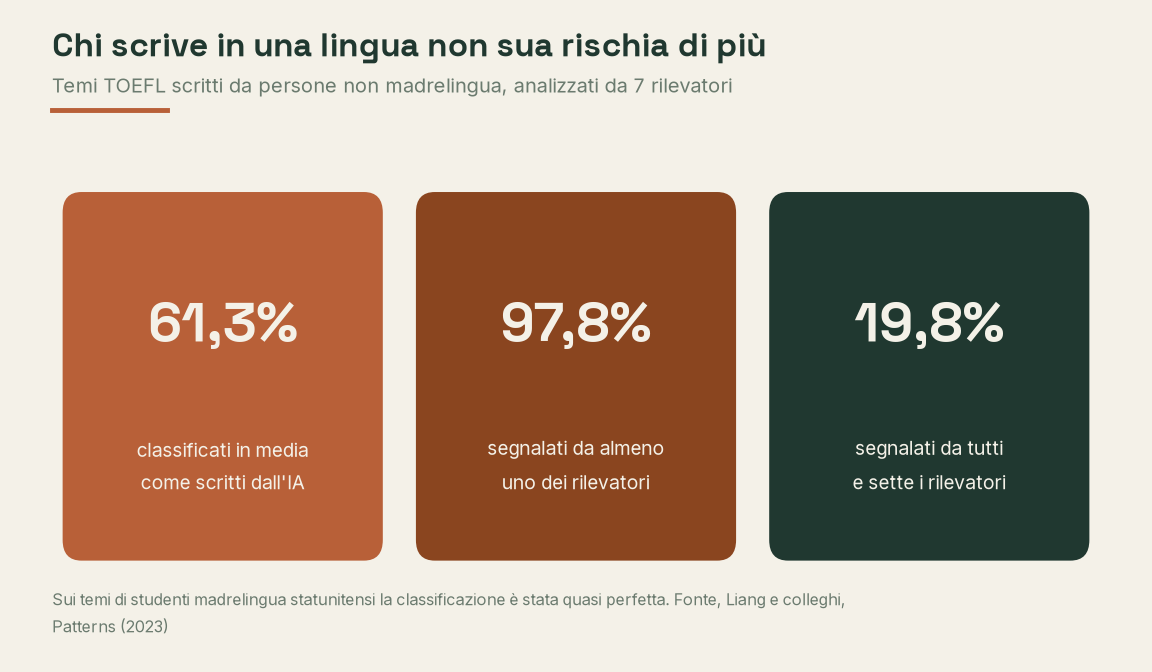
Temi scritti da persone, analizzati da sette rilevatori. Fonte, Liang e colleghi, Patterns (2023).
Sui temi degli studenti madrelingua i rilevatori sono stati quasi perfetti. Sui temi dei non madrelingua, invece, in media il 61,3% è stato scambiato per un testo generato dall'IA, e il 97,8% è stato segnalato da almeno uno dei sette strumenti. La ragione è proprio il modo in cui ragionano. Chi scrive in una lingua che non padroneggia usa parole più semplici e frasi più prevedibili, cioè le stesse caratteristiche che i rilevatori associano all'IA.
Lo studio riguarda l'inglese, e per l'italiano non ho trovato dati equivalenti. In una classe dove ci sono studenti che hanno imparato l'italiano da pochi anni, però, questo risultato dovrebbe far riflettere prima di fidarsi di un punteggio.
Un errore piccolo, su tanti compiti
Turnitin dichiara un tasso di falsi positivi inferiore all'1% a livello di documento, per i documenti con almeno il 20% di scrittura IA, e intorno al 4% a livello di singola frase. Sembrano numeri piccoli, ma vanno moltiplicati per il numero di compiti.
La Vanderbilt University, negli Stati Uniti, ha fatto il conto nell'agosto 2023. Nel 2022 aveva ricevuto circa 75.000 elaborati, per cui anche solo l'1% di errori avrebbe significato circa 750 studenti segnalati ingiustamente. Per questo ha disattivato il rilevatore di Turnitin, scrivendo che lo avrebbe tenuto spento per il prossimo futuro.
Le conseguenze possono arrivare in tribunale. Il 28 gennaio 2026 la Corte suprema dello Stato di New York per la contea di Nassau ha annullato la sanzione che la Adelphi University aveva inflitto a uno studente per un saggio a cui Turnitin aveva dato un punteggio IA del 100%, e ha ordinato di cancellarla dal suo fascicolo. La corte ha criticato il modo in cui l'università aveva deciso, senza pronunciarsi sull'affidabilità dei rilevatori.
E le filigrane digitali?
Esiste un'altra strada, la filigrana. È il produttore del modello a inserire nel testo un segnale statistico invisibile, che poi si può verificare. Google ha descritto il suo sistema, SynthID, su Nature nel 2024 e lo ha reso disponibile con codice aperto. Gli stessi autori però scrivono che la filigrana si indebolisce quando il testo viene modificato o parafrasato, e che funziona solo sui modelli che la adottano.
Anche le regole europee vanno in questa direzione. L'AI Act, all'articolo 50, chiede ai fornitori di sistemi che generano testi, immagini, audio e video di marcare i contenuti in un formato leggibile dalle macchine, e nel giugno 2026 la Commissione europea ha pubblicato la versione finale di un codice di condotta volontario su come farlo. È un passo utile, ma non risolve il caso di uno studente che riscrive con parole sue un testo generato.
Cosa fare in classe
Le linee guida del Ministero dell'Istruzione e del Merito sull'introduzione dell'IA nelle scuole, adottate con il decreto 166 del 9 agosto 2025, non parlano di rilevatori. Chiedono però che l'intervento umano resti centrale e insostituibile, soprattutto nelle situazioni che hanno un impatto sugli studenti. A partire da qui, e dagli studi che ho riportato, propongo alcune abitudini concrete.
- Non usare mai un punteggio come prova. Al massimo è un motivo per parlare con lo studente, non per sanzionarlo.
- Valuta il percorso, non solo il prodotto. Bozze, appunti, versioni successive e un breve colloquio sul testo dicono molto più di qualsiasi rilevatore.
- Dichiara le regole prima. Se è chiaro quando l'IA si può usare e come va dichiarata, si discute meno dopo.
- Fai attenzione a chi scrive in una lingua non sua, perché è il caso in cui i rilevatori sbagliano di più.
- Pensa ai dati degli studenti. Caricare un elaborato su un servizio online significa consegnare a terzi un testo che può contenere nome, cognome e informazioni personali di un minore. Se proprio serve, togli prima i dati personali, per esempio con l'Anonimizzatore IA che distribuiamo gratuitamente per macOS e Windows. Il riconoscimento dei dati avviene sul tuo computer e i documenti restano lì, e il risultato va sempre ricontrollato. Ne ho scritto anche nella guida su come anonimizzare i testi.
Se vuoi ricevere aggiornamenti come questo, crea il tuo account gratuito su retoria.it. Se invece vuoi lavorare su questi temi con il collegio docenti della tua scuola, partendo da casi reali, scrivici.
Nota metodologica
Ho letto per intero gli studi di Weber-Wulff e colleghi (nella versione preprint del luglio 2023, il cui abstract coincide con quello pubblicato), di Liang e colleghi, di Perkins e colleghi (preprint del marzo 2024, la versione pubblicata parla di sei rilevatori e conferma il calo di 17,4 punti) e di Van Vlasselaer e colleghi, oltre alle pagine ufficiali di OpenAI, Turnitin e Vanderbilt, la sentenza sul caso Adelphi e le linee guida del Ministero. Alcune pagine bloccano la lettura automatica, e in quei casi ho consultato la copia conservata dall'Internet Archive.
Nel primo grafico l'accuratezza è la media dei 14 strumenti per ciascun tipo di testo. Lo studio la calcola in tre modi diversi, e l'intervallo va dal valore più basso al più alto. I testi IA senza modifiche raccolgono i due tipi di testo generato dello studio.
Non riporto le percentuali di accuratezza dichiarate dai produttori dei rilevatori, perché non sono verificate in modo indipendente. Non ho trovato decisioni di tribunali italiani su questo tema. I volumi di ricerca vengono dal Keyword Planner di Google per l'Italia, da ottobre 2025 a settembre 2026. Questo articolo non è una consulenza legale.
Fonti
- Weber-Wulff D. e colleghi, «Testing of detection tools for AI-generated text», International Journal for Educational Integrity 19, 26 (2023), DOI 10.1007/s40979-023-00146-z, e preprint su arXiv.
- Liang W., Yuksekgonul M., Mao Y., Wu E., Zou J., «GPT detectors are biased against non-native English writers», Patterns 4(7) (2023), DOI 10.1016/j.patter.2023.100779.
- Perkins M. e colleghi, «Simple techniques to bypass GenAI text detectors», International Journal of Educational Technology in Higher Education 21, 53 (2024), DOI 10.1186/s41239-024-00487-w.
- Van Vlasselaer, Van Droogenbroeck, Spruyt, «Who wrote this? Evaluating the reliability of AI detection tools in higher education», International Journal for Educational Integrity 22, 16 (2026), DOI 10.1007/s40979-026-00226-w.
- OpenAI, pagina del classificatore di testi (31 gennaio 2023, con la nota sul ritiro del 20 luglio 2023).
- Turnitin, articolo sui falsi positivi a livello di frase (14 giugno 2023) e note sul modello di rilevamento.
- Vanderbilt University, comunicazione sulla disattivazione del rilevatore di Turnitin (16 agosto 2023).
- Supreme Court of the State of New York, Nassau County, Newby contro Adelphi University, Index No. 615397/25 (28 gennaio 2026).
- Dathathri S. e colleghi, «Scalable watermarking for identifying large language model outputs», Nature 634 (2024), DOI 10.1038/s41586-024-08025-4.
- Regolamento (UE) 2024/1689 sull'intelligenza artificiale, testo su EUR-Lex, articolo 50, e Commissione europea, codice di condotta sulla trasparenza dei contenuti generati dall'IA.
- Ministero dell'Istruzione e del Merito, decreto 166 del 9 agosto 2025 e linee guida sull'IA nella scuola.
- Google, Keyword Planner, volumi medi mensili di ricerca in Italia (ottobre 2025, settembre 2026), consultati il 22 ottobre 2026.