Più esperto ti senti con l'IA, più sbagli a valutarti
Per dieci anni abbiamo chiamato divario digitale una cosa sola, ovvero il dispositivo che manca, la connessione che non arriva, la licenza che costa troppo. Poi è arrivato lo strumento più potente mai messo in mano a uno studente, ed è gratuito e sta dentro un browser. Il report EduNext 2026 liquida la questione in una riga che vale l'intero capitolo, cioè che non è l'accesso a creare il divario, ma la qualità dell'uso.
La frattura si è spostata dentro la testa di chi lo strumento ce l'ha già. Ha anche un nome tecnico, divario metacognitivo, e misura una distanza precisa, quella fra quanto sei bravo davvero e quanto credi di esserlo mentre lavori con una macchina che scrive meglio di te. Questo punto è molto importante, perché una competenza che non sai di non avere non la puoi colmare.
La biforcazione che si allarga da sola
Il ragionamento di EduNext è netto. Chi usa l'IA in modo strategico, ovvero per formulare domande migliori, costruire interpretazioni più dense, muoversi dentro ambiguità che non si risolvono, ottiene una leva moltiplicativa sulle proprie capacità. Chi la usa come oracolo, delegando la risposta senza sviluppare il giudizio, perde capacità per inutilizzo. E il meccanismo si autoamplifica, visto che chi parte avvantaggiato usa lo strumento in modo più sofisticato e aumenta ancora il vantaggio, mentre chi parte svantaggiato lo usa passivamente e si depotenzia ulteriormente.
È una tesi convincente, e la condividiamo. Ma qui va detta una cosa scomoda, perché noi di Retoria il report lo citiamo spesso e vogliamo citarlo bene. EduNext appoggia la parte sulla perdita di capacità a uno studio del 2011 di Sparrow, Liu e Wegner, il famoso lavoro sui Google effects sulla memoria. Quel risultato non ha retto alla verifica. Nel 2018 il Social Sciences Replication Project di Camerer e colleghi ha riprovato a ottenerlo su tutti gli esperimenti pubblicati su Nature e Science fra il 2010 e il 2015, e su quello studio la replica è fallita, con una direzione dell'effetto coerente ma nessuna significatività, né alla prima raccolta dati né mettendo insieme le due.
Non è un dettaglio da nota a piè di pagina. Vuol dire che la prova del divario metacognitivo non sta nella memoria che si atrofizza, che resta un'ipotesi non confermata. Sta da un'altra parte, ed è una prova più recente e molto più solida.
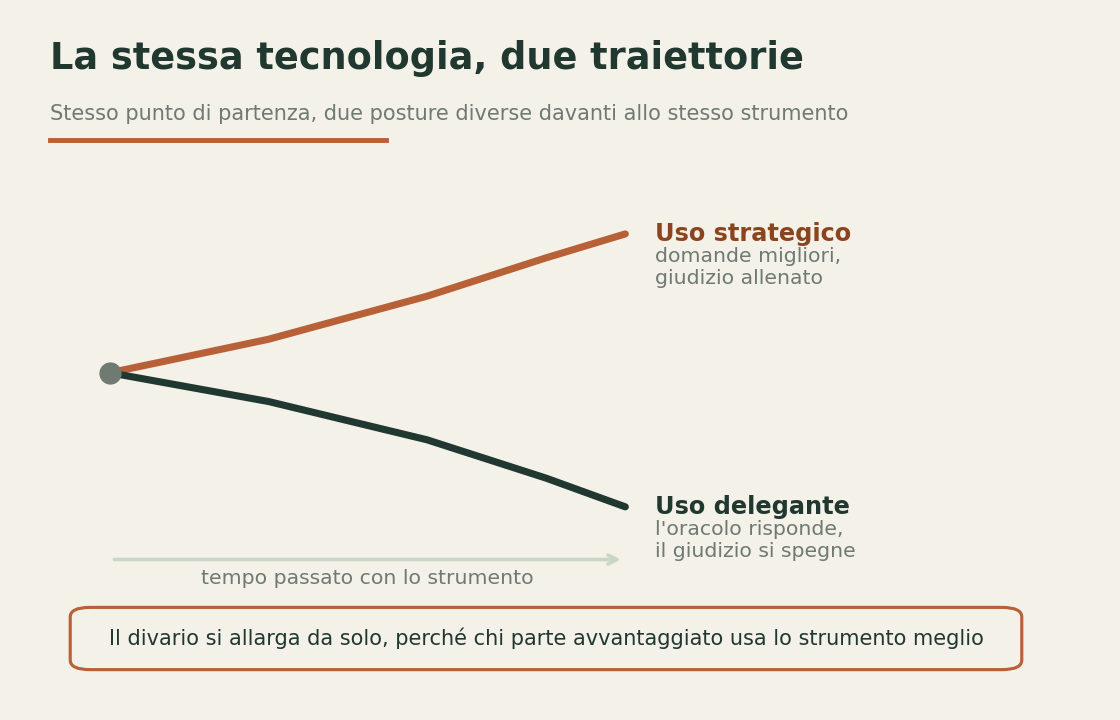 La biforcazione descritta da EduNext. La stessa tecnologia produce esiti opposti in funzione della postura cognitiva di chi la usa. Elaborazione Retoria su Osservatorio Look4ward, Luiss e Intesa Sanpaolo, EDUNext 2026.
Il dato che regge, ovvero la calibrazione che si rompe
A ottobre 2025 Robin Welsch e Daniela da Silva Fernandes dell'Università Aalto hanno pubblicato su Computers in Human Behavior un esperimento che va dritto al punto. Circa 500 partecipanti, due prove, quesiti di ragionamento logico presi dal test di ammissione alle facoltà di giurisprudenza americane. Metà lavora con ChatGPT, metà senza. E a tutti viene chiesto di stimare quanto hanno fatto bene, con un compenso legato all'accuratezza della stima, così che rispondere a caso costi qualcosa.
Il risultato è doppio e va letto tutto insieme. Chi ha usato l'IA ha risolto meglio i quesiti, cosa che nessuno mette in dubbio. E contemporaneamente ha perso la capacità di stimare la propria prestazione, sopravvalutandola in modo significativo. Il titolo che gli autori hanno scelto è più eloquente di qualunque riassunto, ovvero l'IA ti rende più bravo ma non più saggio.
C'è poi il pezzo che dovrebbe far riflettere chiunque progetti formazione. Il classico schema per cui è l'incompetente a sopravvalutarsi qui non si presenta affatto. Si rovescia. Chi si dichiara più alfabetizzato sull'IA si sopravvaluta di più degli altri, non di meno. E il comportamento che lo spiega è banale e osservabile in qualsiasi aula, visto che la maggior parte dei partecipanti ha fatto una sola domanda per quesito. Un passaggio solo. Nessun secondo giro, nessuna verifica, nessun confronto.
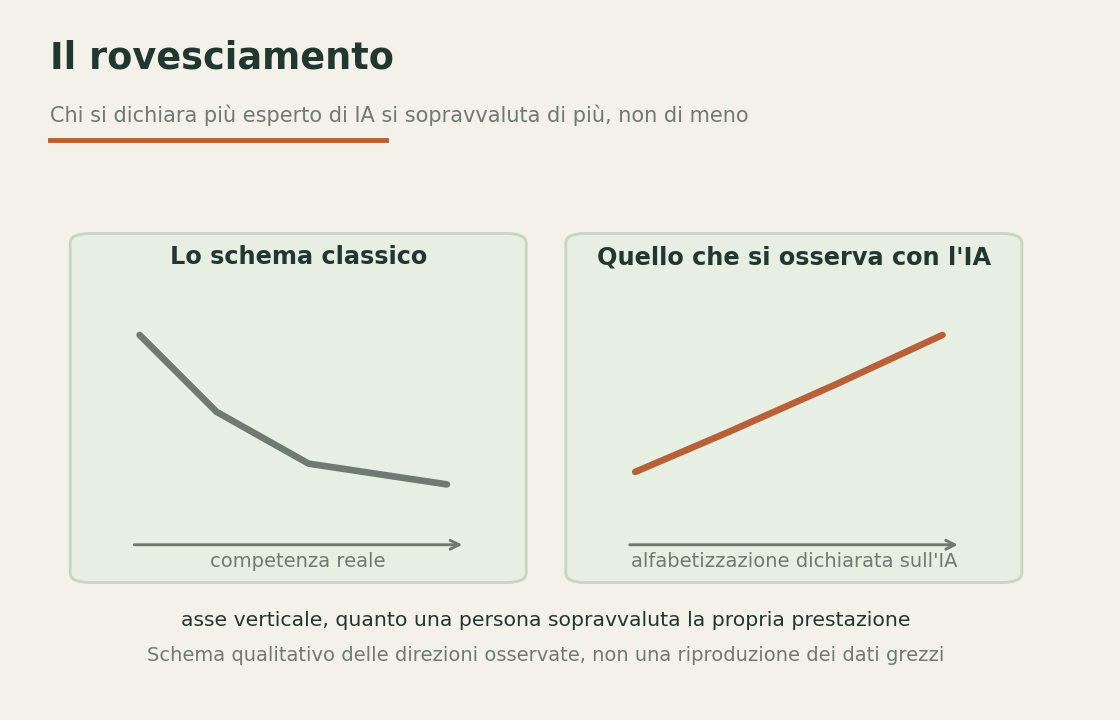 Con l'IA il rapporto si rovescia. Schema qualitativo delle direzioni misurate da Welsch e da Silva Fernandes, Computers in Human Behavior (2025).
Più ti fidi della macchina, meno pensi
Lo stesso meccanismo si vede negli uffici, non solo nelle aule. Alla conferenza CHI 2025 un gruppo di Microsoft Research e della Carnegie Mellon University ha presentato un'indagine su 319 lavoratori della conoscenza, che hanno raccontato casi d'uso reali dell'IA generativa nel proprio lavoro quotidiano. La correlazione che emerge è quasi meccanica. Più fiducia il lavoratore ripone nella capacità dello strumento di svolgere il compito, meno sforzo critico dichiara di avere impiegato. Più fiducia ripone in se stesso, più sforzo critico impiega.
E cambia anche la natura di quello sforzo. Si sposta dal produrre informazione al verificarla, dal risolvere un problema all'integrare una risposta già confezionata. Non è di per sé un peggioramento, a patto che la verifica avvenga davvero. Quando non avviene, resta soltanto l'integrazione, cioè il copia e incolla con una patina di controllo.
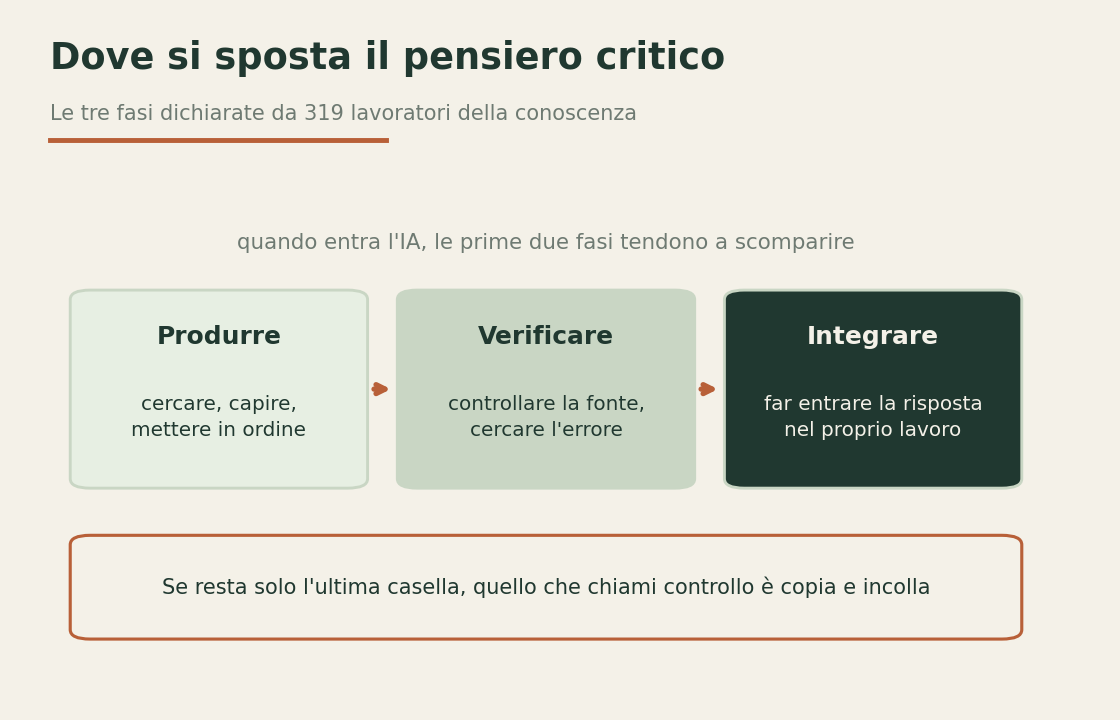 Dove si sposta il pensiero critico quando entra l'IA. Il rischio è che resti solo l'ultimo passaggio. Elaborazione Retoria su Lee e colleghi, CHI 2025.
In aula, la pigrizia metacognitiva
Sul versante didattico la misura più pulita arriva da un esperimento pubblicato nel 2025 sul British Journal of Educational Technology da Fan, Gašević e colleghi. Centodiciassette studenti universitari, quattro condizioni di supporto durante un compito di scrittura, ovvero ChatGPT, un esperto umano, uno strumento di analisi automatica del testo, oppure niente. Il gruppo con ChatGPT ha ottenuto il miglioramento più alto sul punteggio del testo consegnato. Sul guadagno di conoscenza e sul transfer, cioè sulla capacità di riusare quello che avevi imparato in una situazione nuova, nessun vantaggio. Gli autori chiamano il fenomeno pigrizia metacognitiva, ovvero la rinuncia a monitorare il proprio pensiero quando c'è qualcosa che lo fa al posto tuo.
Il quadro si chiude con l'esperimento di Bastani e colleghi, pubblicato nel 2025 su PNAS, su quasi mille studenti di scuola superiore in Turchia. Con accesso libero a GPT-4 durante l'esercitazione i risultati salgono del 48%. Poi arriva l'esame senza assistente, e quegli stessi studenti vanno peggio del 17% rispetto a chi l'assistente non l'ha mai avuto. La versione con vincoli pedagogici incorporati, che i ricercatori chiamano GPT Tutor, azzera il danno. Non è la tecnologia a fare la differenza, è il modo in cui è costruita.
Chi ha letto il nostro articolo sulla penalità di apprendimento dell'IA riconosce lo stesso schema su una scala ancora più grande, ovvero i 26.000 studenti seguiti per trenta mesi da Strömberg, Lei e Wu.
La tensione che il report lascia aperta
A pagina 43 EduNext fa una cosa che i report istituzionali quasi mai fanno, cioè elenca le contraddizioni che non riesce a risolvere. Una riguarda direttamente questo tema. Da un lato chi guida team ibridi avanzati sostiene che ogni mese di ritardo nell'adozione dell'IA è competitività persa, e il mercato non aspetta che le fondamenta cognitive siano costruite. Dall'altro chi studia i processi cognitivi sostiene che la velocità senza fondamenta produce utenti passivi, e che la passività si autoriproduce. Entrambe le posizioni hanno basi empiriche. Il report scrive che la tensione non è componibile al suo interno e richiede scelte politiche che la ricerca può orientare ma non sostituire.
Accanto c'è la seconda contraddizione, altrettanto ruvida. L'IA democratizza l'accesso alla conoscenza, e nello stesso momento i ritorni economici si concentrano su pochissimi attori che controllano l'infrastruttura. Più accesso per molti, più potere per pochissimi. Anche qui il report prende atto senza offrire una sintesi, perché la sintesi non è nei dati.
Noi la leggiamo così. Aspettare non è un'opzione, e nemmeno adottare senza costruire lo è. L'unico spazio praticabile sta nel far crescere le due cose insieme, ovvero introdurre lo strumento e allenare il giudizio dentro la stessa attività, non in due corsi diversi a distanza di mesi.
Quattro mosse che si possono fare lunedì
Non servono piattaforme nuove e non serve aspettare una riforma. Quello che segue è quanto usiamo nelle aule di Retoria, e funziona con i docenti come con i dirigenti d'azienda.
- Prima la tua risposta, poi la macchina. Una bozza scritta bene prima di aprire il modello, anche brutta, anche corta. Chi chiede a freddo non ha nulla con cui confrontare la risposta che riceve.
- Stima prima di sapere. Prima di consegnare, scrivi che voto pensi di prendere. Confrontare la stima con il voto vero è l'esercizio più economico che esista per riparare la calibrazione, ed è esattamente la cosa che l'IA rompe.
- Vietata la domanda singola. Una sola richiesta e via è il comportamento misurato nello studio di Aalto, ed è il marcatore della delega. Si obbliga il secondo giro, ovvero chiedere alla macchina dove potrebbe sbagliarsi e verificare almeno un dato su una fonte esterna.
- Almeno una prova senza. Se l'unica misura che raccogli è una prestazione assistita, non stai misurando l'apprendimento, stai misurando lo strumento.
Il punto per la tua organizzazione
Se stai introducendo l'IA in una scuola, in uno studio o in un'azienda, la domanda giusta non è quale strumento adottare, ma se le persone che lo useranno sanno riconoscere quando la risposta che ricevono è sbagliata. È una cosa che si misura, e conviene misurarla prima e non dopo. Retoria fa esattamente questo, ovvero valuta la prontezza reale di un'organizzazione sull'IA e costruisce il percorso formativo che ne consegue. Scrivici per una valutazione di AI readiness, oppure leggi perché esiste Retoria e come lavoriamo.
Nota metodologica
Le fonti citate non hanno tutte lo stesso peso e ci sembra corretto dirlo. Lo studio di Aalto e quello di Bastani sono esperimenti con assegnazione casuale e misure raccolte in condizioni controllate, per cui reggono un'inferenza causale. Quello di Bastani, però, si è svolto in un solo istituto superiore in Turchia su classi di nona, decima e undicesima in matematica, quindi è forte sul nesso causale e prudente sulla generalizzazione. L'indagine di Microsoft e Carnegie Mellon si basa su racconti dei partecipanti, quindi mostra una correlazione e non una causa, e risente di quanto le persone sanno descrivere il proprio sforzo mentale. Lo studio di Fan e colleghi ha un campione di 117 studenti universitari in un solo compito di scrittura, per cui va letto come segnale e non come legge generale.
Due avvertenze in più. Lo studio di Sparrow, Liu e Wegner del 2011, citato da EduNext e ripreso a suo tempo anche da noi, non ha replicato nel 2018, e da oggi lo trattiamo come ipotesi aperta e non come prova. Il classico effetto Dunning e Kruger, pure citato dal report, è da anni al centro di una discussione statistica seria, perché una parte consistente del fenomeno si spiega con la regressione verso la media e con il modo in cui i dati vengono raggruppati. Per questo in questo articolo non lo usiamo come prova, e il lavoro di Aalto è più utile proprio perché misura la calibrazione in modo diretto invece di dedurla.
Questo articolo non è consulenza legale né clinica. Parla di apprendimento e di organizzazione del lavoro.
Fonti
- Osservatorio Look4ward, Luiss Research Center for Strategic Change "Franco Fontana" e Intesa Sanpaolo (2026). EDUNext: Nuovi scenari per l'Education e le competenze nell'era dell'IA. Licenza CC BY 4.0.
- Welsch, R. e da Silva Fernandes, D. (2025). AI makes you smarter but none the wiser: The disconnect between performance and metacognition. Computers in Human Behavior, 175.
- Lee, H.-P. et al., Microsoft Research e Carnegie Mellon University (2025). The Impact of Generative AI on Critical Thinking: Self-Reported Reductions in Cognitive Effort and Confidence Effects From a Survey of Knowledge Workers. Proceedings of CHI 2025.
- Fan, Y., Tang, L., Le, H., Gašević, D. et al. (2025). Beware of metacognitive laziness: Effects of generative artificial intelligence on learning motivation, processes, and performance. British Journal of Educational Technology.
- Bastani, H., Bastani, O., Sungu, A. et al. (2025). Generative AI without guardrails can harm learning: Evidence from high school mathematics. Proceedings of the National Academy of Sciences, 122(26).
- Camerer, C. F. et al. (2018). Evaluating the replicability of social science experiments in Nature and Science between 2010 and 2015. Nature Human Behaviour.
- Sparrow, B., Liu, J. e Wegner, D. M. (2011). Google effects on memory: Cognitive consequences of having information at our fingertips. Science, 333(6043).
- Gignac, G. E. e Zajenkowski, M. (2020). The Dunning-Kruger effect is (mostly) a statistical artefact: Valid approaches to testing the hypothesis with individual differences data. Intelligence, 80.